01Cosa fa il plugin
Una cosa sola, fatta bene: riconosce i crawler AI e li ferma.
Spuncin blocca i crawler che raccolgono contenuti per addestrare modelli AI, e lascia passare tutto quello che porta lettori al sito. Niente blockchain, niente pagamenti, niente identità verificabili: quella parte resta nel repository di Andromeda per un eventuale seguito.
Lavora su due livelli contemporaneamente, perché uno solo non basta. Alcuni crawler si annunciano e rispettano robots.txt, e per quelli è sufficiente una richiesta cortese. Altri la ignorano, e serve un rifiuto vero. Spuncin scrive l'opt-out in robots.txt e risponde 403, così copre entrambi i casi.
Il claim che possiamo difendere. Spuncin blocca i crawler che si dichiarano. Uno scraper che si finge Chrome è un problema diverso, e risolverlo richiede strumenti che stanno davanti a PHP. Preferiamo dirlo che promettere quello che il plugin non può fare.
02Come riconosciamo un crawler
Tre accorgimenti che servono tutti e tre, nessuno basta da solo.
Il match deve avvenire su token delimitato
Cercare il nome del bot come sottostringa qualunque dentro lo User-Agent sembra la cosa ovvia da fare, ed è la trappola principale di tutto il progetto. Nella lista di partenza esistono nomi come Spider, Code e ExaBot: cercati così colpiscono Baiduspider, Sogou, Screaming Frog, Visual Studio Code ed Exabot di Exalead, cioè tre motori di ricerca, un tool SEO e l'editor di chi programma.
Adesso il nome deve comparire delimitato da inizio o fine stringa, spazio, punto e virgola, parentesi, virgola, più o barra. È la forma in cui i nomi compaiono davvero negli User-Agent reali.
I nomi troppo generici restano fuori
Il confine sui token non basta, perché Code è un token valido dentro Visual Studio Code/1.90.0. Quindici nomi sono quindi esclusi dal riconoscimento a prescindere da cosa faccia il bot: sono crawler marginali, e il costo di non bloccarli è nullo rispetto al danno di fermare per sbaglio un motore di ricerca o l'editor di qualcuno.
I nomi si ordinano dal più lungo al più corto
Senza questo, Applebot vincerebbe su Applebot-Extended e finirebbe nelle statistiche il crawler sbagliato. Sono due cose diverse: il primo alimenta Siri e Spotlight, il secondo è il permesso per l'addestramento.
Cosa succede a una richiesta, in ordine
- robots.txt passa sempreSe la richiesta è per robots.txt viene servita a chiunque, crawler inclusi. È l'unico modo perché l'opt-out arrivi a destinazione.
- Chi scrive sul sito passaAutori, editori e amministratori del sito non vengono controllati, così uno User-Agent sfortunato non può chiudere fuori chi ci lavora. Gli utenti semplicemente registrati vengono controllati come tutti: su un sito con registrazione aperta, esentare ogni account significherebbe che basta iscriversi per aggirare il plugin.
- Confronto con la listaSolo lavoro su stringhe, nessuna rete. È l'operazione più economica e va per prima.
- Verifica dei motori di ricercaSolo se il passo precedente ha trovato qualcosa. Qui parte una query DNS, ed è il motivo per cui viene dopo e non prima.
- 403 e conteggioLa pagina di rifiuto non nomina né il crawler né Spuncin.
Perché quest'ordine conta. Se la verifica dei motori di ricerca girasse per prima, basterebbe mandare uno User-Agent contenente "bingbot" per costringere il server a una query DNS bloccante: con una ventina di richieste si occupano tutti i processi PHP e il sito sparisce, a costo zero per chi attacca. Interrogando il DNS solo per le richieste che hanno già l'aria di essere un crawler, quella superficie non esiste.
Chi non viene bloccato mai
Googlebot, Bingbot, Applebot, DuckDuckBot, YandexBot, Baiduspider e PetalBot passano a qualunque livello, e non è un'opzione che l'utente possa togliere. La verifica non si fida dello User-Agent: fa un reverse DNS sull'IP, controlla che l'host finisca con il dominio giusto, poi risolve quell'host e verifica che l'IP torni. È il metodo che Google e Bing pubblicano per farsi riconoscere, e impedisce che chiunque ottenga un lasciapassare copiando una stringa.
Stesso trattamento per i bot che generano l'anteprima quando si condivide un link su Facebook, WhatsApp, Telegram e gli altri. Per quelli non esiste un metodo di verifica pubblicato, ma non sono crawler AI e bloccarli trasforma ogni link condiviso in un rettangolo grigio.
03Le tecniche che abbiamo scartato
Quasi tutte per lo stesso motivo: un plugin PHP entra in gioco troppo tardi.
| Tecnica | Perché sarebbe utile | Perché l'abbiamo lasciata |
|---|---|---|
| Fingerprinting TLS (JA4) | È la tecnica più efficace del 2026 contro gli scraper mascherati. Analizza l'handshake TLS, che non si può falsificare da JavaScript perché dipende dalla libreria compilata nel client. | Quando PHP viene eseguito l'handshake è concluso da tempo e quei dati non esistono più. Servirebbe un modulo del web server o un proxy davanti. Fuori portata per architettura, non per scelta. |
| Challenge JavaScript (proof-of-work, Turnstile e simili) | Un browser vero la risolve senza accorgersene, uno scraper di massa ci rimette tempo di calcolo e smette di guadagnarci. | Ricade nell'articolo 5(3) ePrivacy e complicherebbe sia il plugin sia la review. Rimandata, eventualmente come opzione spenta di default. |
| Verifica degli IP pubblicati | OpenAI e Perplexity pubblicano i range dei propri crawler. Confrontarli smaschera chi si spaccia per GPTBot. | Richiederebbe di scaricare quelle liste dai loro server, cioè chiamate esterne. Vietato dalle linee guida e in contrasto con la scelta di non contattare nessuno. |
| Honeypot (link invisibile che un umano non clicca) | Funziona, ed è la tecnica di Blackhole for Bad Bots che ha 30.000 installazioni. | Rimandata a dopo la prima release. Aggiunge markup a ogni pagina del sito e va valutata con calma. |
| Segnali comportamentali (chi scarica l'HTML e mai gli asset, rate per IP) | Intercetta chi si maschera bene. | Richiede di conservare stato tra una richiesta e l'altra, cioè dati sui visitatori. Va contro la scelta di non salvare nulla di personale. |
| Lista di user-agent aggiornata da remoto | I bot nuovi arriverebbero senza aspettare un aggiornamento del plugin. | La Guideline 8 vieta di usare servizi terzi per gestire liste di dati aggiornate di continuo. La lista sta dentro il plugin e si aggiorna con esso. I bot rilevanti nuovi escono due o tre volte l'anno. |
La posizione onesta. I sistemi anti-bot perfetti non esistono. Cloudflare, con miliardi di dati e risorse, viene aggirato ogni giorno. Il nostro argomento non è "siamo imbattibili" ma che i crawler dichiarati li fermiamo davvero, e su quelli mascherati non promettiamo nulla che non possiamo mantenere.
04Le quattro categorie
La lista di partenza non è un elenco di bot cattivi, è un catalogo.
I nomi vengono dal progetto ai.robots.txt, licenza MIT. Quella lista però cataloga i crawler che hanno a che fare con l'AI, non quelli da bloccare: dentro convivono cose molto diverse, e bloccare quella sbagliata fa un danno concreto a chi installa il plugin. La classificazione è nostra, fatta con revisione incrociata separata su chi bloccava troppo e su chi bloccava troppo poco.
| Categoria | Quanti | Cosa sono | Bloccati da |
|---|---|---|---|
| Addestramento | 55 | Raccolgono contenuti per addestrare modelli, costruire dataset o rivendere dati. Il sito non riceve nulla in cambio. GPTBot, ClaudeBot, CCBot, Bytespider. | livello 1 |
| Ricerca AI | 55 | Alimentano un motore di ricerca o un assistente che può mandare visite. PerplexityBot e OAI-SearchBot citano la fonte con un link cliccabile. | livello 2 |
| Aperto da una persona | 29 | Non sono crawler: è qualcuno che ha chiesto a un assistente di aprire quella pagina adesso. ChatGPT-User, Claude-User, Perplexity-User. | livello 3 |
| Nome ambiguo | 15 | Il nome è troppo generico per cercarlo dentro uno User-Agent. Vale a prescindere da cosa fa il bot. | mai |
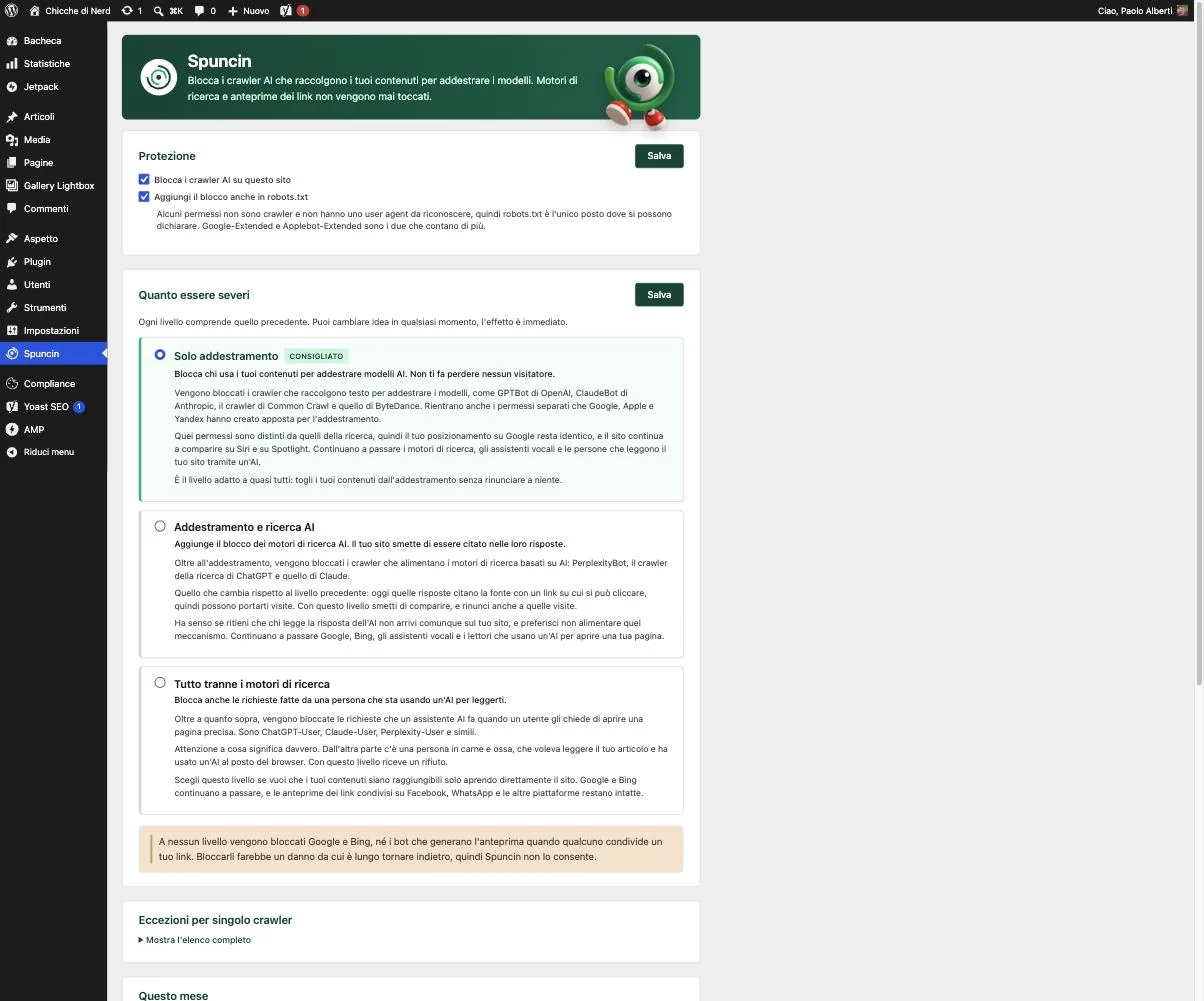
I livelli sono cumulativi e il predefinito è il primo. Ognuno dichiara nell'interfaccia cosa costa, non solo cosa blocca: senza quella spiegazione la gente sceglie il più severo per istinto e poi si accorge mesi dopo di aver perso qualcosa.
Il caso che merita attenzione è il terzo livello. Dall'altra parte di quelle richieste non c'è un programma che raccoglie dati, c'è una persona che voleva leggere un articolo e ha usato un'AI al posto del browser. Bloccarla è una scelta legittima ma va fatta sapendo cosa comporta, ed è per questo che il testo nell'interfaccia lo dice senza girarci intorno.
05Il caso robots.txt
La scoperta che ha cambiato l'architettura del plugin.
Due dei permessi più utili che esistano non sono crawler e non hanno uno User-Agent. Esistono soltanto come nome da scrivere in robots.txt.
Google-Extended doesn't have a separate HTTP request user agent string. Crawling is done with existing Google user agent strings; the robots.txt user-agent token is used in a control capacity. Documentazione Google sui crawler
Applebot-Extended does not crawl webpages itself; it is only used to determine how to use the data crawled by Applebot. Documentazione Apple su Applebot
Un plugin che guarda solo lo User-Agent non potrà mai agire su quei due, per quanto sia scritto bene. E sono proprio i permessi che permettono di uscire dall'addestramento di Google e Apple senza perdere una singola visita, perché il posizionamento su Google resta a Googlebot e la presenza su Siri resta ad Applebot. Da qui la scelta di scrivere anche robots.txt.
Il dettaglio da non perdere di vista. WordPress esegue template_redirect prima di controllare se la richiesta è per robots.txt. Senza una guardia esplicita, il blocco 403 risponderebbe anche a chi va a leggere le regole, e la RFC 9309 stabilisce che un 4xx su robots.txt significa "nessuna restrizione": si finirebbe per comunicare ai crawler educati l'esatto contrario di quello che si intende, con le due metà del sistema che si annullano a vicenda. La guardia c'è, con il commento che spiega perché, e un test che fallisce se qualcuno la rimuove.
06Privacy, e perché la dashboard è spartana
Una scelta di prodotto travestita da dettaglio tecnico.
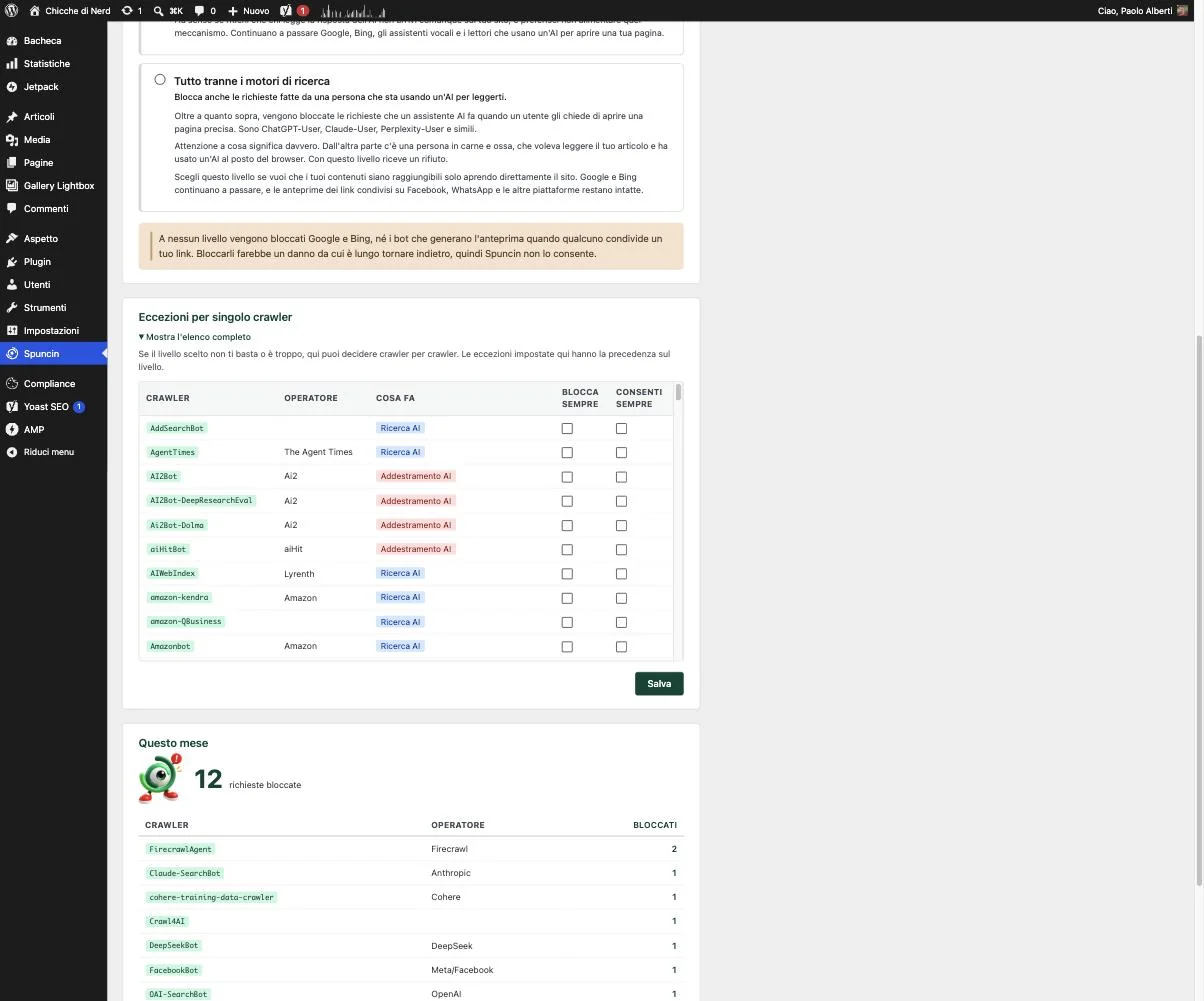
Nel database finisce una riga per crawler per giorno, con un contatore. Nient'altro: nessun indirizzo IP, nessuno User-Agent per esteso, nessun URL, nessun evento singolo. Non c'è dato personale da esportare o cancellare, e questo è il motivo per cui il plugin non implementa gli hook GDPR di export ed erase: non avrebbero niente da fare.
La conseguenza è che la dashboard mostra solo eventi di sicurezza. Niente visitatori unici, niente pagine più viste, niente grafici sul traffico umano. Non è pigrizia.
Il ragionamento. Le linee guida EDPB 2/2023 stabiliscono che l'articolo 5(3) ePrivacy si applica anche agli header HTTP e all'IP, e persino alla loro ricezione passiva. L'esenzione esiste, ed è nella WP29 Opinion 9/2014: le tecniche usate per la sicurezza del servizio richiesto dall'utente non necessitano di consenso. Ma con un paletto preciso: nessuna finalità secondaria, e se un dato serve a più scopi l'esenzione vale solo se lo sono tutti. Una riga di analytics contaminerebbe l'intera raccolta e ci servirebbe un banner di consenso, che su un plugin gratuito da installare in trenta secondi è la morte. La tentazione di aggiungere due statistiche carine va rimandata, e in quel caso come modulo separato con il suo consenso.
Chi risponde di cosa
Il gestore del sito è il titolare del trattamento. Noi che scriviamo il plugin non siamo né titolari né responsabili, perché nessun dato lascia il suo server. Questo però regge solo finché il plugin non chiama nessuno: nel momento in cui contattasse un nostro server, quel server riceverebbe l'IP del sito cliente e la faccenda cambierebbe del tutto.
È anche il motivo per cui le immagini della mascotte stanno dentro il pacchetto invece di essere caricate da spuncin.com. Sarebbe stato più comodo per aggiornarle, ma l'handbook privacy di WordPress cita quel caso specifico: caricare un'immagine da una fonte esterna a ogni installazione traccia indirettamente l'uso di tutte le installazioni. Le abbiamo convertite in WebP, che pesa il 68% in meno del PNG, e il problema di peso si è risolto da solo.
07Dove siamo e cosa manca
Il plugin gira su un sito vero. È installato su chicchedinerd.net e verificato su tutti e tre i livelli: blocca i crawler di addestramento, lascia passare Googlebot, i browser e chi legge tramite ChatGPT, e scrive 56 direttive in robots.txt sotto il blocco di Yoast.
Curiosità dal campo: l'hosting Tophost blocca già per conto suo GPTBot, ClaudeBot e altri, con un 406 a livello nginx che colpisce anche i file statici. La prova è stata fatta con i sette crawler che quel filtro lascia passare.
Verifiche automatiche
La suite in spuncin/tests/ prova 39 User-Agent reali su tutti e tre i livelli, più i casi di specificità dei nomi, il contenuto di robots.txt, le eccezioni per singolo crawler e l'esistenza degli asset. Gira senza WordPress, quindi si lancia con php tests/test-detection.php in un secondo.
Prima di pubblicare su wordpress.org
| Cosa | Stato |
|---|---|
Account spuncin su wordpress.org | da registrare il campo Contributors deve puntare a un utente esistente |
| Due screenshot per la scheda | da fare livelli e statistiche |
| readme.txt conforme | fatto 113 caratteri di descrizione breve, 5 tag |
| Traduzione italiana | fatta 48 stringhe su 48 |
| Attribuzione MIT della lista | fatta CREDITS.txt e sezione nel readme |
| Compatibilità PHP 7.4 | verificata il 22,7% delle installazioni reali sta sotto PHP 8 |
Rimandato di proposito
Honeypot, segnali comportamentali e challenge progressiva servono contro gli scraper mascherati e vanno affrontati insieme, non a pezzi. L'aggiornamento remoto della lista si può aggiungere come opzione spenta di default con fallback locale, ma solo quando avremo un motivo concreto per volerlo.